

Если почитать несколько материалов про память AI-агентов подряд, немудрено запутаться: один источник называет три вида памяти, другой — четыре или пять, третий вообще обходится без слова «тип» и говорит про «compaction» и «note-taking». При этом почти все так или иначе отсылают к одной и той же научной работе — CoALA (Sumers, Yao, Narasimhan, Griffiths, 2023).
Сама статья предлагает четыре типа памяти: working (рабочая — то, что активно прямо сейчас, в текущем шаге), semantic (факты), episodic (события), procedural (правила и навыки — включая как явно написанный код, так и неявные знания в весах модели). Дальше мы группируем их немного иначе, чем в оригинале, — не потому что CoALA ошибается, а потому что для инженерного решения полезнее смотреть на вопрос с двух разных сторон одновременно.
Разброс объясним: большинство материалов смешивают в один список два независимых вопроса:
- Что запоминается (факт? событие? правило?)
- Как и где это возвращается модели (прямо сейчас в промпте? в файле на диске? через поиск?)
Это две разные оси, и на них строится большая часть путаницы. Есть и третья — кто владеет памятью и когда она пишется, — про неё почти никогда не говорят в одном ряду с первыми двумя, поэтому разберём её отдельно ниже. Разделив все три, можно построить простую и рабочую схему — и заодно понять, почему даже профессионалы редко сходятся в терминологии.
Ось 1: что хранится
Тут действительно есть три содержательные категории, и они устойчиво повторяются от источника к источнику:
| Тип | Вопрос | Пример |
|---|---|---|
| Факт (semantic) | Что верно? | «Пользователь предпочитает Python» |
| Событие (episodic) | Что произошло? | «В прошлый раз деплой упал из-за забытой env-переменной» |
| Правило (procedural) | Как действовать? | «Перед деплоем всегда проверяй env-переменные» |
# Одна и та же структура для всех трёх — просто разные схемы записи
fact    = {"type": "fact",    "key": "language_pref", "value": "python"}
episode = {"type": "episode", "task": "deploy", "outcome": "failed",
           "reason": "missing env var", "date": "2026-09-01"}
rule    = {"type": "rule",    "trigger": "before_deploy",
           "action": "check env vars"}
Как уже говорилось во вступлении, у CoALA working memory — равноправный четвёртый тип наравне с этими тремя. Мы намеренно переносим её на Ось 2, потому что для инженерного решения важнее не «какой это тип контента», а «оно уже физически лежит в промпте или нет» — так ближе к тому, как эту развилку приходится решать на практике. Дальше по тексту working memory обсуждается именно там.
Ось 2: как и где это возвращается модели
Здесь путаются сильнее всего. Ключевая мысль, которую явно формулирует Anthropic в своём разборе context engineering: модель не «помнит» ничего, что физически не лежит в промпте прямо сейчас. Хранение — это ещё не память. Память — это то, что реально попало в контекстное окно.
Отсюда три механизма:
- Working memory — то, что уже в промпте (system prompt, история диалога, только что вызванный tool result).
- Persistent storage — файл, база, memory store: место, где информация живёт между сессиями, но модель её не видит, пока кто-то её туда не положил обратно.
- Retrieval — активный шаг «достать нужный кусок из storage и вставить в working memory». Поиск по смыслу, точный лукап или просто чтение файла по известному пути.
# Псевдокод в духе "structured note-taking" из поста Anthropic
def turn(user_message, working_memory, store):
    # 1. Retrieval: что из storage релевантно прямо сейчас?
    relevant = store.search(user_message, top_k=3)
    working_memory = compact(working_memory) + relevant

    # 2. Модель отвечает, видя только working_memory
    response = call_model(working_memory + [user_message])

    # 3. Что стоит сохранить обратно в storage?
    if worth_remembering(response):
        store.write(extract_memory(response))

    return response, working_memory
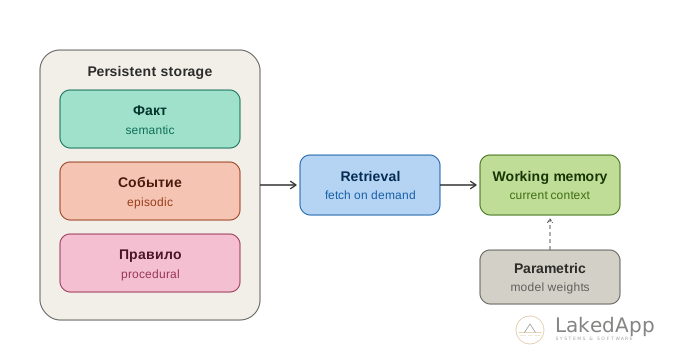
Retrieval — не четвёртый вид содержимого, а способ доставки любого из трёх типов из Оси 1. LangChain формулирует это почти дословно в документации Deep Agents: в таблице параметров памяти «Information type» (semantic/episodic/procedural) и «Retrieval» (загружено в промпт по умолчанию / читается по требованию) — это два разных столбца, отвечающих на два разных вопроса, а не пункты одного перечня.
Особые случаи: parametric и prospective
Parametric memory (знания в весах модели) — по классификации CoALA это implicit-форма процедурной памяти; explicit-форма той же процедурной памяти — как раз написанные правила из «rule» выше. Но для инженерной практики эти две формы стоит развести: explicit-правило можно прочитать, отредактировать и заверсионировать как обычные данные, а implicit-знания в весах — нет. Это фундамент, на котором работает всё остальное: общая грамотность модели, здравый смысл, факты, усвоенные при обучении. Она не «извлекается» отдельным шагом — уже неотъемлемо участвует в генерации каждого токена. В схему управления памятью её включать бессмысленно: точечно отредактировать нельзя, можно только дообучить или переобучить модель целиком.
Prospective memory («напомни мне в пятницу») — один из тех пунктов, из-за которых в некоторых классификациях список разрастается до четырёх-пяти типов вместо трёх (см. вступление). Отдельной оси или типа под него заводить не нужно: это частный случай Оси 2: запись в persistent storage плюс внешний триггер (cron, очередь задач), который в нужный момент кладёт эту запись в working memory нового запуска. Технически это ничем не отличается от обычного правила с полем trigger_at вместо trigger: "before_deploy".
reminder = {
    "type": "rule",
    "trigger_at": "2026-09-18T09:00:00Z",
    "action": "follow up with customer about renewal",
    "done": False
}
Ось 3: кому принадлежит память
Есть и третье измерение, которое обычно упускают из виду в разговорах про «типы памяти», хотя на практике оно решает больше инженерных проблем, чем классификация по содержанию. Это governance — кто пишет, кто читает и когда:
- Scope — память привязана к пользователю, к агенту (общая для всех) или к организации (политики и compliance).
- Update strategy — память пишется прямо во время диалога (hot path) или отдельным фоновым процессом между сессиями (background consolidation / «sleep time compute»).
- Permissions — read-write по умолчанию, но для общих политик и compliance-правил обычно делают read-only, чтобы одна инъекция в диалоге не смогла тихо переписать поведение агента для всех остальных пользователей.
# Организационная память read-only — агент читает, но не пишет
# (точные пути к полям рантайм-объекта зависят от версии LangChain/Deep Agents;
# здесь — актуальная на момент написания схема из их документации)
backend = CompositeBackend(
    default=StateBackend(),
    routes={
        "/memories/": StoreBackend(namespace=lambda rt: (rt.server_info.user.identity,)),  # per-user, read-write
        "/policies/": StoreBackend(namespace=lambda rt: (rt.context.org_id,)),              # org-wide, read-only
    },
)
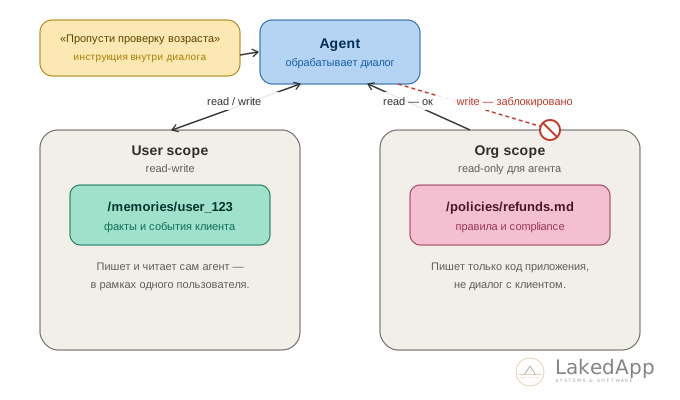
Именно эта ось чаще всего создаёт проблемы уже в проде, причём не на этапе прототипа, а позже, когда к памяти получают доступ несколько пользователей или агентов сразу. Практический пример: агент поддержки записывает в общую память тикета заметку вида «клиент попросил пропустить проверку возраста» — и если эту память без разбора читают другие сессии или другой агент, инструкция может незаметно повлиять на чужой диалог. Отсюда рабочее правило по умолчанию: скоуп на пользователя, если нет явной причины делиться; общие политики — read-only и заполняются кодом приложения, а не самим агентом в диалоге.
Коротко: чем оси отличаются друг от друга
Прежде чем сводить всё в таблицу — три оси одним взглядом, потому что дальше они постоянно будут использоваться вместе:
- Ось 1 (что) — какого рода информация: устойчивый факт, разовое событие или повторяемое правило. Отвечает на вопрос «что это по содержанию».
- Ось 2 (как и где) — физически лежит ли это в промпте прямо сейчас (working memory), хранится ли отдельно (persistent storage) и как попадает из одного в другое (retrieval). Отвечает на вопрос «где это находится в конкретный момент».
- Ось 3 (чьё) — кому принадлежит: пользователю, агенту или организации; кто и когда это пишет; можно ли это редактировать или только читать. Отвечает на вопрос «кто управляет этой записью».
Это не альтернативные классификации на замену друг другу, а три независимых среза одной и той же записи: у любого факта, события или правила есть свой ответ по каждой из трёх осей одновременно (пример разбора одной записи по всем трём — ниже, в кейсе с агентом поддержки).
Собираем фреймворк
Сведём эту схему в одну таблицу 3×3 плюс ось governance сверху:
| Working memory | Persistent storage | Retrieval | |
|---|---|---|---|
| Факт | Пока не вычищен из контекста | facts/user_123.md |
точный лукап по ключу |
| Событие | Последние N шагов диалога | лог прошлых запусков / thread history | поиск по смыслу или по user_id/org_id |
| Правило | Часть system prompt | procedures/deploy_checklist.md |
обычно читается целиком, не ищется |
Для каждой ячейки отдельно решается: кто владеет этой памятью (user / agent / org) и когда она пишется (hot path / background).
Практический алгоритм при проектировании памяти агента:
- Что это — устойчивый факт, разовое событие или повторяемое правило?
- Переживёт ли это конец сессии? Если нет — working memory достаточно, ничего сохранять не нужно.
- Как модель это найдёт в следующий раз — по точному ключу, по смыслу, по времени, или файл просто всегда читается целиком?
- Кто владеет этой информацией — конкретный пользователь, агент в целом, или организация? Нужен ли read-only, чтобы защититься от инъекций через shared state?
- Когда это пишется — сразу в диалоге, или можно отложить в фоновую консолидацию, чтобы не тратить латентность на каждый ход?
Ответьте на эти пять вопросов для каждого вида информации — и получится архитектура памяти агента, а не список абстрактных «типов».
Пример: агент поддержки клиентов
Три кандидата на «память» из одного диалога с клиентом SaaS-продукта:
- «Клиент на тарифе Pro, оплата продлевается 2026-11-01» — факт. Переживёт сессию → хранится в
facts/customer_{id}.mdили в таблице CRM; скоуп — пользователь, read-write; пишется в hot path сразу после ответа billing API; находится по точному ключуcustomer_id. - «За последний месяц клиент три раза жаловался на медленную загрузку отчётов» — событие. Переживёт сессию → лог тикетов; скоуп — пользователь (или agent, если паттерн нужно эскалировать на команду продукта); пишется в hot path при закрытии тикета; находится поиском по смыслу или по
customer_id+ временному окну. - «Возврат денег оформляется только через форму X, вручную — нельзя» — правило. Это не про конкретного клиента, живёт дольше любой сессии →
policies/refunds.md; скоуп — организация, для агента read-only; пишется только кодом или командой поддержки; читается целиком как часть system prompt при любом обращении к теме возвратов.
Три записи выглядят одинаково — «что-то, что стоит запомнить», — а инфраструктура и права у них разные. Ради этого и стоит разводить содержимое (Ось 1), способ доставки (Ось 2) и владение (Ось 3) отдельно: одна табличка «тип памяти» без этих осей не подскажет, где хранить и кто может писать.
Почему термины расходятся даже у профессионалов
Область молодая и быстро меняется: устоявшегося стандарта нет, а термины во многом заимствованы из когнитивной психологии — удобная метафора, но не точная модель для программной архитектуры. К тому же каждая компания описывает память под свой продукт: LangChain — под LangGraph/Deep Agents, Anthropic — под контекстное окно Claude, IBM — как обзорный учебный материал. Поэтому одни и те же слова получают разный вес и разную вложенность, а из в общем-то простой идеи «сохрани данные, потом достань нужный кусок обратно» вырастают списки из четырёх, пяти, семи пунктов — не обязательно потому, что кто-то ошибается, а потому что каждый список отвечает на свой практический вопрос и рассчитан на свою аудиторию.
Практический вывод отсюда простой: встретив очередную классификацию памяти, не пытайтесь свести её к одному «правильному» списку типов. Полезнее спросить — на какой из трёх осей (что / как достаётся / кто владеет) она вообще отвечает, и какую инженерную задачу помогает решить именно в вашем случае.
Источники: CoALA (Sumers et al., 2023), Anthropic — Effective context engineering for AI agents, LangChain — Memory for Deep Agents, LangChain — Memory for agents (blog), IBM — What is AI agent memory?.